Domain dementiert.de kaufen?
Wir ziehen mit dem Projekt
dementiert.de um.
Sind Sie am Kauf der Domain
dementiert.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain dementiert.de kaufen?
Was sind die grundlegenden Unterschiede zwischen UTF-8, UTF-16 und UTF-32 Zeichenkodierungssystemen?
UTF-8 verwendet eine variable Anzahl von Bytes pro Zeichen, UTF-16 verwendet 2 Bytes pro Zeichen und UTF-32 verwendet 4 Bytes pro Zeichen. UTF-8 ist platzsparender für Zeichen im ASCII-Bereich, während UTF-32 für alle Zeichen immer die gleiche Größe verwendet. UTF-16 und UTF-32 können Probleme mit Endianness verursachen, die UTF-8 nicht hat. **
Was ist der Unterschied zwischen Leugnen, Abstreiten und Verneinen?
Leugnen bezieht sich auf die bewusste Ablehnung oder Verweigerung der Existenz oder Wahrheit einer Aussage oder eines Ereignisses. Abstreiten bedeutet, eine Behauptung oder Anschuldigung vehement zu leugnen oder zu bestreiten. Verneinen hingegen bezieht sich auf die einfache Verneinung einer Aussage, ohne eine starke Ablehnung oder Bestreitung. **
Ähnliche Suchbegriffe für UTF-32
Top-Angebote
Produkte zum Begriff UTF-32:
-
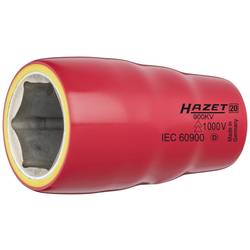
Hazet 900KV-32 900KV-32 Steckschlüsseleinsatz isoliert 32 mm 32 mmOberfläche: schutzisoliert IEC 60900:2018 Made In Germany Antrieb: Vierkant hohl 12,5 mm (1/2 Zoll) Abtrieb: Außen-Sechskant-Tractionsprofil Schlüsselweite: 32 mm Abmessungen / Länge: 66 mm Durchmesser d1 (am Abtrieb): 46.5 mm Durchmesser d2 (am Antrieb): 27 mm Schutzisolierung bis 1000V Für Handbetätigung33,99 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Unterschiede zwischen UTF-8, UTF-16 und UTF-32, und wie beeinflussen diese Zeichenkodierungsschemata die Speichergröße und die Darstellung von Zeichen in verschiedenen Anwendungen und Systemen?
UTF-8 ist eine variable Zeichenkodierung, die 1 bis 4 Bytes pro Zeichen verwendet, während UTF-16 feste 2 oder 4 Bytes pro Zeichen verwendet und UTF-32 feste 4 Bytes pro Zeichen verwendet. Dies bedeutet, dass UTF-8 effizienter für die Speicherung von Zeichen im ASCII-Bereich ist, während UTF-32 mehr Speicherplatz benötigt, aber alle Zeichen einheitlich darstellt. In Anwendungen und Systemen, die hauptsächlich mit ASCII-Zeichen arbeiten, ist UTF-8 aufgrund seiner Effizienz weit verbreitet, während UTF-16 und UTF-32 in Anwendungen verwendet werden, die eine einheitliche Darstellung aller Zeichen erfordern, wie z.B. in der Programmierung und bei der Verarbeitung von Texten in verschiedenen Sprachen. **
-
Was ist der Unterschied zwischen den Verben "leugnen", "verleugnen", "bestreiten" und "abstreiten"?
"Leugnen" bedeutet, die Existenz oder Wahrheit einer Sache zu leugnen oder zu leugnen, dass man etwas getan hat. "Verleugnen" bedeutet, etwas zu leugnen oder zu leugnen, dass man mit einer bestimmten Person oder Gruppe in Verbindung steht. "Bestreiten" bedeutet, etwas zu leugnen oder zu bestreiten, dass etwas wahr ist oder stattgefunden hat. "Abstreiten" bedeutet, etwas zu leugnen oder zu bestreiten, dass man etwas getan hat oder dass etwas wahr ist. **
-
Was ist UTF?
UTF steht für "Unicode Transformation Format" und ist ein Standard zur Kodierung von Zeichen in Computern. Es ermöglicht die Darstellung von Text in verschiedenen Sprachen und Zeichensätzen, darunter auch Sonderzeichen und Emojis. UTF-8 ist die am weitesten verbreitete Variante von UTF und verwendet eine variable Anzahl von Bytes zur Kodierung von Zeichen. UTF spielt eine wichtige Rolle bei der internationalen Kommunikation und der Unterstützung verschiedener Schriftsysteme. Es löst Probleme, die bei älteren Zeichencodierungen wie ASCII auftreten, die nur begrenzte Zeichensätze unterstützen. **
-
Was sind die wichtigsten Unterschiede zwischen UTF-8 und UTF-16 Zeichenkodierungsschema?
UTF-8 ist eine variable Zeichenkodierung mit einer Byte-Repräsentation von 1 bis 4 Bytes, während UTF-16 eine feste Zeichenkodierung mit einer Byte-Repräsentation von 2 oder 4 Bytes ist. UTF-8 kann alle Unicode-Zeichen darstellen, während UTF-16 einige Zeichen als Surrogate-Paare kodiert. UTF-8 ist platzsparender für westliche Sprachen, während UTF-16 effizienter für ostasiatische Sprachen ist. **

Kann UTF 8 Umlaute?
Ja, UTF-8 kann Umlaute darstellen. UTF-8 ist ein Unicode-Zeichenkodierungsstandard, der es ermöglicht, eine Vielzahl von Zeichen aus verschiedenen Sprachen und Schriftsystemen darzustellen, einschließlich Umlaute wie ä, ö, ü. Umlaute werden in UTF-8 als mehrere Bytes codiert, je nachdem, welcher Umlaut dargestellt werden soll. UTF-8 ist einer der am weitesten verbreiteten Zeichenkodierungsstandards und wird in vielen modernen Anwendungen und Systemen verwendet. Durch die Verwendung von UTF-8 können Umlaute und andere Sonderzeichen korrekt und plattformübergreifend dargestellt werden. **
Was ist UTF-8?
UTF-8 steht für "Unicode Transformation Format 8-bit" und ist ein Zeichenkodierungsstandard, der verwendet wird, um Zeichen aus verschiedenen Schriftsystemen in Computern darzustellen. Es ist weit verbreitet und unterstützt eine breite Palette von Zeichen, einschließlich der meisten Schriftzeichen der Welt. UTF-8 ist besonders nützlich für die Darstellung von Text in mehreren Sprachen und die Unterstützung von internationalen Websites und Anwendungen. **
Top-Angebote
Produkte zum Begriff UTF-32:
-
Was sind die grundlegenden Unterschiede zwischen UTF-8, UTF-16 und UTF-32 Zeichenkodierungssystemen?
UTF-8 verwendet eine variable Anzahl von Bytes pro Zeichen, UTF-16 verwendet 2 Bytes pro Zeichen und UTF-32 verwendet 4 Bytes pro Zeichen. UTF-8 ist platzsparender für Zeichen im ASCII-Bereich, während UTF-32 für alle Zeichen immer die gleiche Größe verwendet. UTF-16 und UTF-32 können Probleme mit Endianness verursachen, die UTF-8 nicht hat. **
-
Was ist der Unterschied zwischen Leugnen, Abstreiten und Verneinen?
Leugnen bezieht sich auf die bewusste Ablehnung oder Verweigerung der Existenz oder Wahrheit einer Aussage oder eines Ereignisses. Abstreiten bedeutet, eine Behauptung oder Anschuldigung vehement zu leugnen oder zu bestreiten. Verneinen hingegen bezieht sich auf die einfache Verneinung einer Aussage, ohne eine starke Ablehnung oder Bestreitung. **
-
Was sind die wichtigsten Unterschiede zwischen UTF-8, UTF-16 und UTF-32, und wie beeinflussen diese Zeichenkodierungsschemata die Speichergröße und die Darstellung von Zeichen in verschiedenen Anwendungen und Systemen?
UTF-8 ist eine variable Zeichenkodierung, die 1 bis 4 Bytes pro Zeichen verwendet, während UTF-16 feste 2 oder 4 Bytes pro Zeichen verwendet und UTF-32 feste 4 Bytes pro Zeichen verwendet. Dies bedeutet, dass UTF-8 effizienter für die Speicherung von Zeichen im ASCII-Bereich ist, während UTF-32 mehr Speicherplatz benötigt, aber alle Zeichen einheitlich darstellt. In Anwendungen und Systemen, die hauptsächlich mit ASCII-Zeichen arbeiten, ist UTF-8 aufgrund seiner Effizienz weit verbreitet, während UTF-16 und UTF-32 in Anwendungen verwendet werden, die eine einheitliche Darstellung aller Zeichen erfordern, wie z.B. in der Programmierung und bei der Verarbeitung von Texten in verschiedenen Sprachen. **
-
Was ist der Unterschied zwischen den Verben "leugnen", "verleugnen", "bestreiten" und "abstreiten"?
"Leugnen" bedeutet, die Existenz oder Wahrheit einer Sache zu leugnen oder zu leugnen, dass man etwas getan hat. "Verleugnen" bedeutet, etwas zu leugnen oder zu leugnen, dass man mit einer bestimmten Person oder Gruppe in Verbindung steht. "Bestreiten" bedeutet, etwas zu leugnen oder zu bestreiten, dass etwas wahr ist oder stattgefunden hat. "Abstreiten" bedeutet, etwas zu leugnen oder zu bestreiten, dass man etwas getan hat oder dass etwas wahr ist. **
Ähnliche Suchbegriffe für UTF-32
-
Hazet 900KV-32 900KV-32 Steckschlüsseleinsatz isoliert 32 mm 32 mmOberfläche: schutzisoliert IEC 60900:2018 Made In Germany Antrieb: Vierkant hohl 12,5 mm (1/2 Zoll) Abtrieb: Außen-Sechskant-Tractionsprofil Schlüsselweite: 32 mm Abmessungen / Länge: 66 mm Durchmesser d1 (am Abtrieb): 46.5 mm Durchmesser d2 (am Antrieb): 27 mm Schutzisolierung bis 1000V Für Handbetätigung33,99 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
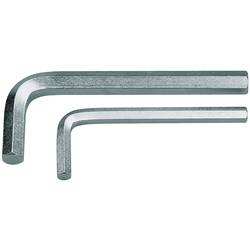
Gedore 42 32 Winkelschraubendreher 32 mm 32 6342710Gedore 42 32 Winkelschraubendreher, Innen-6-kant 32 mm Gedore 42 32 Winkelschraubendreher, Innen-6-kant 32 mm Merkmale: Ausführung nach DIN ISO 2936Vanadium-Stahl 61CrSiV5verchromt Technische Merkmale: Abrollschutz: Neinantimagnetisch: NeinAusführung funkenarm: NeinForm der Klinge: SechskantGesamtbreite [mm]: 155 mmGesamthöhe [mm]: 36 mmGesamtlänge [mm]: 345 mmGriff vorhanden: Nein Gedore Code-Nummer: 6342710 EAN: 401088663427189,99 €*Versand: 4,95 €Sichere Weiterleitung zum Anbieter
-
Was ist UTF?
UTF steht für "Unicode Transformation Format" und ist ein Standard zur Kodierung von Zeichen in Computern. Es ermöglicht die Darstellung von Text in verschiedenen Sprachen und Zeichensätzen, darunter auch Sonderzeichen und Emojis. UTF-8 ist die am weitesten verbreitete Variante von UTF und verwendet eine variable Anzahl von Bytes zur Kodierung von Zeichen. UTF spielt eine wichtige Rolle bei der internationalen Kommunikation und der Unterstützung verschiedener Schriftsysteme. Es löst Probleme, die bei älteren Zeichencodierungen wie ASCII auftreten, die nur begrenzte Zeichensätze unterstützen. **
-
Was sind die wichtigsten Unterschiede zwischen UTF-8 und UTF-16 Zeichenkodierungsschema?
UTF-8 ist eine variable Zeichenkodierung mit einer Byte-Repräsentation von 1 bis 4 Bytes, während UTF-16 eine feste Zeichenkodierung mit einer Byte-Repräsentation von 2 oder 4 Bytes ist. UTF-8 kann alle Unicode-Zeichen darstellen, während UTF-16 einige Zeichen als Surrogate-Paare kodiert. UTF-8 ist platzsparender für westliche Sprachen, während UTF-16 effizienter für ostasiatische Sprachen ist. **
-
Kann UTF 8 Umlaute?
Ja, UTF-8 kann Umlaute darstellen. UTF-8 ist ein Unicode-Zeichenkodierungsstandard, der es ermöglicht, eine Vielzahl von Zeichen aus verschiedenen Sprachen und Schriftsystemen darzustellen, einschließlich Umlaute wie ä, ö, ü. Umlaute werden in UTF-8 als mehrere Bytes codiert, je nachdem, welcher Umlaut dargestellt werden soll. UTF-8 ist einer der am weitesten verbreiteten Zeichenkodierungsstandards und wird in vielen modernen Anwendungen und Systemen verwendet. Durch die Verwendung von UTF-8 können Umlaute und andere Sonderzeichen korrekt und plattformübergreifend dargestellt werden. **
-
Was ist UTF-8?
UTF-8 steht für "Unicode Transformation Format 8-bit" und ist ein Zeichenkodierungsstandard, der verwendet wird, um Zeichen aus verschiedenen Schriftsystemen in Computern darzustellen. Es ist weit verbreitet und unterstützt eine breite Palette von Zeichen, einschließlich der meisten Schriftzeichen der Welt. UTF-8 ist besonders nützlich für die Darstellung von Text in mehreren Sprachen und die Unterstützung von internationalen Websites und Anwendungen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.